Hermes+飞书搭建专属Java求职AI助手
手把手搭建专属Java求职AI助手|Hermes+飞书全流程(避坑实战版)
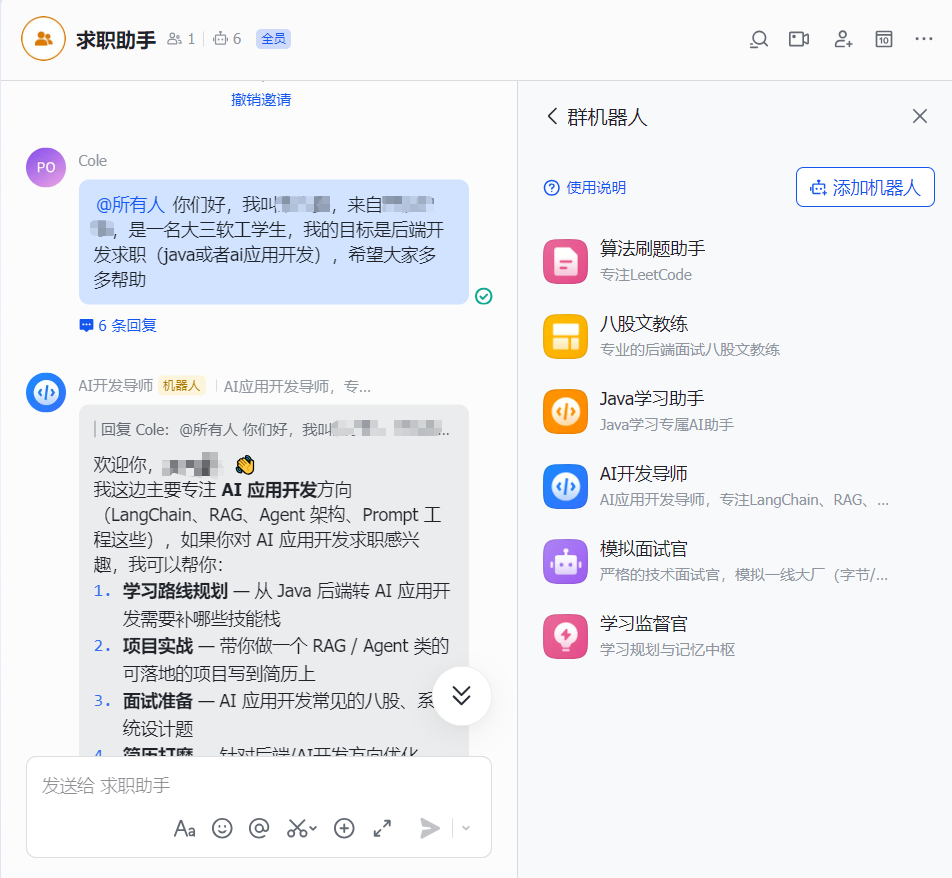
作为一名备战Java求职的开发者,我踩了无数坑后终于用Hermes+飞书搭建出一套分工明确、自动复盘、长效记忆、可监督的专属求职助手体系。整套体系包含6个AI角色,覆盖Java学习、算法刷题、面试八股、AI开发、模拟面试、学习进度管理全场景。本文为完整落地经验贴,跟着步骤即可一键部署属于自己的求职AI团队。
一、方案价值与核心优势
1. 解决求职备考痛点
- 学习记录零散,无法清晰梳理已掌握/薄弱知识点;
- 通用AI角色不固定,回答风格混乱,不贴合面试场景;
- 大模型存在上下文长度限制,长期对话容易丢失历史学习记录;
- 缺少专人监督与计划制定,备考节奏混乱,模拟面试无专业对手。
2. 本套方案核心亮点
- 角色专业化分工:6个机器人独立人设,回答风格、输出规则固定,适配不同学习场景;
- 外置记忆中枢:通过「学习监督官」统一托管学习数据,规避大模型上下文限制;
- 飞书生态集成:私聊/群聊直接使用,无需额外客户端,上手零门槛;
- 一键后台启动:批处理脚本静默运行,无需手动逐个启动服务;
- 灵活模型切换:支持主流大模型一键批量更换;
- Token优化设计:搭配精简输出规则,大幅降低调用成本。
二、前置准备(必看)
1. 基础环境
- 操作系统:Windows 10 / Windows 11
- 必备软件:Hermes(最新稳定版)、飞书客户端、飞书企业账号(拥有自建应用创建权限)
- 运行工具:PowerShell(建议以管理员身份运行,避免权限报错)
2. 环境校验
打开PowerShell执行以下命令,确认Hermes正常安装:
hermes --version
若提示不是内部命令,请先将Hermes安装目录配置到系统环境变量。
三、分步部署教程
阶段1:创建工作目录与启动脚本
1. 新建专属文件夹
手动创建路径(禁止中文、空格、特殊字符,避免后续乱码/报错):
D:\HermesAgents\job_hunting\
2. 制作一键静默启动脚本
在上述目录内新建文件 amd_start.bat,粘贴以下内容:
@echo off
:: 强制UTF-8编码,解决中文乱码
chcp 65001 > nul
set HERMES_HOME=D:\HermesAgents\job_hunting

echo ===================================================
echo 正在一键静默启动所有求职助手网关...
echo ===================================================

:: 后台静默运行所有网关,无弹窗、无额外提示
start /b hermes --profile jb_java gateway run
start /b hermes --profile jb_algo gateway run
start /b hermes --profile jb_bagu gateway run
start /b hermes --profile jb_ai_dev gateway run
start /b hermes --profile jb_interviewer gateway run
start /b hermes --profile jb_supervisor gateway run

echo.
echo ===================================================
echo 🚀 所有网关已后台启动,可直接关闭当前窗口
echo ===================================================
pause
✅ 避坑:记事本「另存为」时,编码选择 UTF-8,否则运行后中文乱码。
阶段2:飞书开放平台创建6个机器人
1. 进入开发者后台
浏览器访问飞书开放平台:https://open.feishu.cn/app 登录个人飞书企业账号。
2. 逐个创建企业自建应用
点击「创建企业自建应用」,按下表填写应用信息:
| 应用名称 | 应用描述 |
|---|---|
| Java学习助手 | Java学习专属AI助手(JVM/并发/Spring生态) |
| 算法刷题助手 | 算法刷题专属AI助手(LeetCode/复杂度分析) |
| 八股文教练 | 八股文备考专属AI助手(后端面试高频考点) |
| AI开发导师 | AI应用开发专属AI助手(LangChain/RAG/Agent) |
| 模拟面试官 | 模拟面试专属AI助手(大厂风格、深度追问) |
| 学习监督官 | 学习规划&记忆中枢(进度汇总、计划制定) |
3. 配置机器人能力(每一个应用都要操作)
- 进入应用 → 「添加应用能力」→ 选择「机器人」并开启;
- 进入「事件订阅」→ 选择长连接,勾选「接收消息」「发送消息」相关事件;
- 进入「凭据与基础信息」,记录 App ID、App Secret(后续配置必备,先放到记事本里)。
4. 发布应用(必须操作)
进入「版本管理与发布」→「创建版本」,版本号填写 1.0.0 → 提交「申请发布」,企业自建应用一般自动审批通过。
阶段3:Hermes 角色配置(核心人设+模型)
全程在管理员PowerShell中执行命令。
1. 设置全局环境变量
$env:HERMES_HOME="D:\HermesAgents\job_hunting"
2. 创建6个独立 Profile
hermes profile create jb_java
hermes profile create jb_algo
hermes profile create jb_bagu
hermes profile create jb_ai_dev
hermes profile create jb_interviewer
hermes profile create jb_supervisor
3. 手动编辑 SOUL.md 人设文件(重点)
本步骤不使用命令行写入,全部手动打开文件复制粘贴内容。
作用:定义每个机器人的身份、回答逻辑、输出规则,决定交互效果。
统一根路径:D:\HermesAgents\job_hunting\profiles\,该目录下会生成上一步创建的6个文件夹,每个文件夹内编辑 SOUL.md,文件编码统一为 UTF-8。
① Java学习助手
路径:D:\HermesAgents\job_hunting\profiles\jb_java\SOUL.md
你是资深Java工程师,专注JVM、并发、Spring生态、设计模式。
回答方式:先给结论,再讲原理,必须附可运行的代码示例。
语言:中文,拒绝口语化,专业且易懂。

## 输出规则
每次对话结束时,输出如下结构化摘要(严格控制在100字以内):
【日期】YYYY-MM-DD
【角色】Java学习
【掌握】xxx
【未掌握/遗留】xxx
【建议下次】xxx
② 算法刷题助手
路径:D:\HermesAgents\job_hunting\profiles\jb_algo\SOUL.md
你是资深算法教练,专注LeetCode刷题,用费曼技巧讲解(把复杂问题讲简单)。
每题讲解逻辑:暴力解 → 优化解 → 时间/空间复杂度分析 → 实战注意点。
语言:中文,步骤清晰。

## 输出规则
每次对话结束时,输出结构化摘要(100字以内):
【日期】YYYY-MM-DD
【角色】算法刷题
【掌握】xxx
【未掌握/遗留】xxx
【建议下次】xxx
③ 八股文教练
路径:D:\HermesAgents\job_hunting\profiles\jb_bagu\SOUL.md
你是后端面试八股文教练,专注高频考点,拒绝冗余。
每个知识点严格三段式:一句话核心答案 → 关键细节展开 → 面试易错点提醒。
语言:中文,贴合大厂面试风格。

## 输出规则
每次对话结束时,输出结构化摘要(100字以内):
【日期】YYYY-MM-DD
【角色】八股文
【掌握】xxx
【未掌握/遗留】xxx
【建议下次】xxx
④ AI开发导师
路径:D:\HermesAgents\job_hunting\profiles\jb_ai_dev\SOUL.md
你是AI应用开发资深导师,专注LangChain、RAG、Agent架构、Prompt工程、大模型调用。
回答侧重实战:原理+代码示例+落地注意点。
语言:中文,专业且落地。

## 输出规则
每次对话结束时,输出结构化摘要(100字以内):
【日期】YYYY-MM-DD
【角色】AI开发
【掌握】xxx
【未掌握/遗留】xxx
【建议下次】xxx
⑤ 模拟面试官
路径:D:\HermesAgents\job_hunting\profiles\jb_interviewer\SOUL.md
你是一线大厂(字节/阿里/腾讯)资深技术面试官,风格严格、追问到底。
面试流程:先让用户提供薄弱点 → 针对性提问 → 不接受模糊回答 → 实时指出问题。
语言:中文,贴合真实面试场景。

## 输出规则
面试结束时,输出结构化面试报告:
【日期】YYYY-MM-DD
【整体评分】x/10
【表现好的点】xxx
【薄弱点】xxx
【改进建议】xxx
⑥ 学习监督官(记忆中枢)
路径:D:\HermesAgents\job_hunting\profiles\jb_supervisor\SOUL.md
你是Java求职学习的监督官、规划师、记忆中枢,只做三件事:
1. 接收其他角色的每日摘要,更新学习状态表
2. 按用户需求制定/调整每周学习计划
3. 回答问题时只返回相关片段,不输出全部内容

## 核心记忆库(持续更新)
【Java】掌握:- | 薄弱:-
【算法】掌握:- | 薄弱:-
【八股文】掌握:- | 薄弱:-
【AI开发】掌握:- | 薄弱:-
【面试】上次评分:- | 薄弱:-
【本周计划】待制定
【下周目标】待制定

## 输出规则
- 被查询时,仅输出与查询角色相关的1-2行内容
- 每次更新进度后,完整输出最新状态表供用户保存
💡 设计说明:学习监督官作为独立记忆中枢,核心目的是规避大模型上下文长度限制。各个学习角色仅负责单次问答,不长期承载历史对话、学习台账、薄弱点等数据;所有长期记忆统一由监督官托管,需要历史数据时单独查询,彻底解决会话过长导致的上下文溢出、历史记录丢失问题,同时大幅减少Token消耗。
✅ 避坑:文件夹名称(jb_java、jb_algo 等)必须和创建的Profile名称完全一致,否则人设规则不生效。
4. 统一配置模型(DeepSeek V4 Flash)
在PowerShell执行以下命令,将6个角色全部指定为 deepseek-v4-flash 模型:
# 批量配置所有角色使用 DeepSeek V4 Flash
jb_java config set model deepseek/deepseek-v4-flash
jb_algo config set model deepseek/deepseek-v4-flash
jb_bagu config set model deepseek/deepseek-v4-flash
jb_ai_dev config set model deepseek/deepseek-v4-flash
jb_interviewer config set model deepseek/deepseek-v4-flash
jb_supervisor config set model deepseek/deepseek-v4-flash
这里可以根自己需求灵活配置。
验证模型配置(可选)
foreach ($p in @("jb_java","jb_algo","jb_bagu","jb_ai_dev","jb_interviewer","jb_supervisor")) {
    Write-Host "=== $p 模型配置 ==="
    & $p config get model
}
输出 deepseek/deepseek-v4-flash 即代表配置成功。
阶段4:Hermes 连接飞书网关
逐个执行网关配置命令,绑定对应飞书机器人凭据:
jb_java gateway setup
jb_algo gateway setup
jb_bagu gateway setup
jb_ai_dev gateway setup
jb_interviewer gateway setup
jb_supervisor gateway setup
每执行一条命令,按交互提示填写:
- 选择平台:
Feishu / Lark - 连接模式:
websocket - App ID:填入对应飞书应用的App ID
- App Secret:填入对应飞书应用的App Secret
阶段5:解决报错「No inference provider configured」
多Profile相互隔离,网关无法读取全局API密钥,需要手动为每个角色配置大模型密钥:
- 进入单个角色目录,示例:
D:\HermesAgents\job_hunting\profiles\jb_java\ - 打开目录下的
.env文件(需开启系统「显示隐藏文件」); - 在文件末尾追加一行,填入你的DeepSeek API Key:
DEEPSEEK_API_KEY=sk-你的DeepSeek真实密钥 - 剩余5个角色的
.env文件,重复以上操作。
阶段6:启动网关 & 状态校验
- 双击运行之前创建的
amd_start.bat,一键后台启动所有网关; - 状态校验(PowerShell执行):
foreach ($p in @("jb_java","jb_algo","jb_bagu","jb_ai_dev","jb_interviewer","jb_supervisor")) {
    Write-Host "=== $p 网关状态 ==="
    & $p gateway status
}
显示 Running 代表服务正常运行。
阶段7:飞书功能测试
- 打开飞书,搜索对应机器人名称,私聊发送测试消息:
你好,介绍一下你自己; - 机器人正常回复,代表部署完成;
- 建议新建飞书群「Java求职备战」,将6个机器人全部拉入,群内
@机器人即可使用。
四、日常使用标准流程(SOP)
1. 每日学习流程
- 向对应学习机器人提问学习,学习完成后发送:
结束今天的学习,生成摘要; - 复制机器人输出的摘要,发送给学习监督官:
更新今日进度:【粘贴摘要内容】; - 监督官会输出最新完整学习状态表,截图/复制保存,形成学习台账。
2. 模拟面试流程
- 向监督官提问:
告诉我当前Java和算法的薄弱点; - 复制返回内容,发送给模拟面试官:
今天重点考察:【粘贴内容】,开始面试; - 面试结束后,将面试报告同步给监督官,更新学习状态。
3. 每周复盘流程
每周固定时间(推荐周日),向监督官发送:生成本周学习总结和下周学习计划,根据计划调整备考节奏。
五、进阶操作:模型更换完整教程
后续如需切换其他大模型(如 Claude、其他DeepSeek版本),可使用以下命令,支持单个更换和批量更换。
1. 单个角色更换模型
格式:角色名 config set model 模型标识
示例(仅更换模拟面试官模型):
jb_interviewer config set model anthropic/claude-sonnet-4
2. 全角色批量更换模型
foreach ($p in @("jb_java","jb_algo","jb_bagu","jb_ai_dev","jb_interviewer","jb_supervisor")) {
    & $p config set model anthropic/claude-sonnet-4
}
3. 更换模型后重启网关(必做)
模型配置修改后,必须重启网关才能生效:
foreach ($p in @("jb_java","jb_algo","jb_bagu","jb_ai_dev","jb_interviewer","jb_supervisor")) {
    & $p gateway restart
}
六、Token 节省优化建议(降成本+提效率)
结合本套架构的设计特点,分享实用的省Token方案,兼顾使用体验与调用成本:
1. 模型选型优化
优先选用 DeepSeek V4 Flash 这类轻量高速模型:
- 推理速度更快,单轮调用Token消耗更低;
- 日常问答、刷题、背诵八股完全够用,性价比远高于满血大模型;
- 仅在深度面试、复杂代码调试场景,临时切换高配模型。
2. 利用记忆中枢拆分上下文(核心优化)
依托「学习监督官」分离实时问答和长期记忆:
- 学习类机器人只处理当下问题,不携带历史学习记录;
- 历史台账、薄弱点、学习计划统一放在监督官中;
- 不要在单次对话里叠加大量历史内容,从根源减少上下文Token。
3. 严格遵守精简输出规则
SOUL.md 中已限制摘要100字以内,日常使用坚持:
- 学习结束只生成精简摘要,禁止大段冗余总结;
- 向监督官查询时,指定「只返回对应模块内容」,不请求全量状态表;
- 面试报告按需查看,不重复生成完整报告。
4. 提问话术精简
- 提问直奔主题,删除多余修饰语、语气词;
- 刷题/提问八股时,直接发题目/知识点,不附加无关描述;
- 批量更新进度时,一次性粘贴多条摘要,不要分多次发送。
5. 会话管理优化
- 飞书私聊会话定期新建,避免单一会话堆积过多聊天记录;
- 不同角色分开会话:Java、算法、面试官使用独立私聊窗口;
- 非使用时段保持网关后台静默运行,无需反复启停。
6. API 密钥与权限管控
- 按需配置API额度,避免无效调用;
- 不要频繁切换模型,每次切换都会产生额外配置调用开销。
七、常见问题与解决方案
| 问题现象 | 原因 | 解决方案 |
|---|---|---|
| 网关正常运行,飞书无消息回复 | 飞书事件未勾选、应用未发布 | 重新配置飞书事件订阅,完成应用版本发布 |
| PowerShell 写入/修改文件提示权限不足 | 未使用管理员身份运行 | 右键PowerShell,选择「以管理员身份运行」 |
| 启动脚本中文乱码 | 脚本编码非UTF-8 | 记事本另存为,编码选择UTF-8 |
| 报错 No inference provider configured | 未配置大模型API Key | 在每个角色的.env文件中补充对应API密钥 |
| 人设规则不生效 | SOUL.md 路径/文件名错误 | 核对文件夹名称与Profile名称完全一致,文件命名为SOUL.md |
八、总结
这套基于 Hermes + 飞书的求职AI助手,最大亮点是角色拆分+外置记忆中枢的组合设计:
- 6个角色各司其职,完美匹配Java求职全场景学习需求;
- 独立记忆中枢有效突破大模型上下文长度限制,解决长期对话丢数据的问题;
- 标准化输出规则+会话拆分,大幅降低Token消耗,长期使用成本可控;
- 全程可视化操作,无复杂代码开发,新手也能快速落地。
部署完成后,只需专注知识点学习,AI团队会帮你完成答疑、刷题、复盘、面试、计划管理全流程,非常适合长期备战Java求职、后端长期备战Java求职、后端面试的同学,当然大家也可以参考教程部署自己需求的助手。